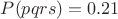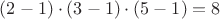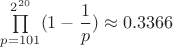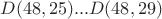Научный форум dxdy

Математика, Физика, Computer Science, Machine Learning, LaTeX, Механика и Техника, Химия,
Биология и Медицина, Экономика и Финансовая Математика, Гуманитарные науки


На страницу Пред.  1 ... 329, 330, 331, 332, 333  След.
 Re: Пентадекатлон мечты
Аватара пользователя
EUgeneUS в сообщении #1735558 писал(а):
Восемь правильных остатков по модулю 125.

А какие 8, если не секрет? :-)

Я вот вижу 4: 25, 50, 75 и 100.

 Re: Пентадекатлон мечты
Аватара пользователя
Dmitriy40
Тут одна мысль посетила. Возможно, поможете подтвердить или опровергнуть.

Оцениваем перспективность паттернов:

Код:
1-2-18-3-(10)
1-3-18-2-(10)


Исходя из вероятности, первый - лучше. Так как вероятность попасть в $pqrs$ выше, чем вероятность попасть в $pq$.
Однако, разница между $P(pq)$ и $P(pqrs)$ небольшая. Путь будут такие типовые вероятности:
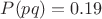
$P(pq) = 0.19$
$P(pqr) = 0.25$
$P(pqrs) = 0.21$

А теперь посмотрим с точки зрения скорости фильтрации.
1. Если на место с ожидаемым pqrs попадает
а) pq. То долго раскладываем на два множителя, потом быстро проверяем их на простоту, и бракуем.
б) pqr. То менее долго раскладываем на два множителя, потом быстро проверяем их на простоту, и опять раскладываем непростой множитель на два. Быстро проверяем их на простоту и бракуем.

2 С другой стороны, если на место с ожидаемым pq попадает
а) pqr. Раскладываем на два множителя. Проверяем на простоту. Бракуем, как не простые.
б) pqrs Раскладываем на два множителя. Проверяем на простоту. Бракуем, как не простые.

Не кажется ли, что второй тип паттернов будет считаться быстрее, и это может нивелировать разницу в вероятностях?

-- добавлено через 3 минуты --

Yadryara в сообщении #1735562 писал(а):
А какие 8, если не секрет? :-)

Я вот вижу 4: 25, 50, 75 и 100.


А Вы, опять проверяете по модулю число, а не итератор.
Да, по модулю пять - если проверять итератор, или по модулю 125 - если проверять числа. Будет $n-1=4$ хороших остатка.

Я про другое
Если
а) проверяем итератор, а не числа
б) проверяем по модулям до 5 включительно.
в) по модулю 3 есть два хороших остатка

Тогда по модулю $2 \cdot 3 \cdot 5 = 30$ будет $(2-1) \cdot (3-1) \cdot (5-1) = 8$ хороших остатков.

 Re: Пентадекатлон мечты
Аватара пользователя
EUgeneUS в сообщении #1735563 писал(а):
А Вы, опять проверяете по модулю число, а не итератор.

Мне пока лень вникать что такое итератор.

8 разрешённых остатков не по модулю 125, а по модулю $64\cdot729\cdot125$

 Re: Пентадекатлон мечты
EUgeneUS в сообщении #1735563 писал(а):
Путь будут такие типовые вероятности:
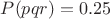
$P(pq) = 0.19$
$P(pqr) = 0.25$
$P(pqrs) = 0.21$

[...]

Не кажется ли, что второй тип паттернов будет считаться быстрее, и это может нивелировать разницу в вероятностях?
Да, при столь близких вероятностях может быть pq выгоднее - позволяют быстрее отбросить кандидата если хоть один делитель найден.
Только Ваши рассуждения не совсем точны: случай 1а идентичен обоим случаям 2а и 2б - так и так надо найти первый делитель и по остатку бракуем. А величина этого вот делителя не зависит от формата ожидания, только от самого числа, которое одинаково для любых форматов мест. Так что слово "долго" в 1а и 1б излишне, долго будет лишь если оба делителя велики, но тогда столь же долгими будут и 2а,2б.
Остаётся лишь случай 1б. Там да, если делитель найден небольшой, то второе разложение не сильно быстрее первого.
Но тут вмешивается другой момент: достаточно много делителей не слишком большие и обнаруживаются относительно быстро. Вероятность числу не иметь делителя меньше $2^{20}$ (и больше $100$) всего
$\prod\limits_{p=101}^{2^{20}}(1-\dfrac{1}{p})\approx0.3366$
(а до 1е9 вероятность 0.22). Т.е. значительная часть разложений, особенно при задействовании ECM, относительно быстро находит небольшие делители. И в таких случаях второе разложение не должно сильно ухудшать картину, оно ведь тоже с той же вероятностью найдёт ещё один небольшой делитель ... Да и вообще случай pqr при ожидаемых pqrs не 100% вероятен, так что влияние случая 1б на общее время ещё ослаблено.
Плюс не забывайте что в пункте 1а частное надо проверять на простоту, а в пунктах 2а и 2б лишь на составное, что несколько быстрее (помнится давало 10%-15% общей скорости, но уже не помню в каком варианте проверок).
С другой стороны, замена pqrs на pq требует размещения двух простых (или куба одного), что увеличивает LCM, что замедляет все операции (особенно разложение).
Но навскидку не готов сказать какой вариант стабильно быстрее, зависит от вероятностей и реализации проверок.

(Дальше только если LCM меняется при переходе от pqrs к pq)

Но это всё про проверку одного кандидата.
А от замены pqrs на pq проверять придётся непрогнозируемо больше кандидатов. Да, Вы занимались этим расчётом, но на мой взгляд там сильны стат.флуктуации и для задачи поиска любого решения они сильнее влияют чем незначительные изменения мат.ожидания.
Вот пример для простейшего паттерна D12-3 список решений до 1е5:
Код:
? forstep(x=3,1e5,3, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
1275, 1926, 8226, 9162, 10323, 10674, 12051, 14049, 16677, 17181, 17667, 17739, 19941, 20619, 22476, 24723, 25773, 28677, 28926, 30474, 31338, 40077, 40914, 41274, 41517, 43803, 44052, 44163, 45123, 49149, 54585, 54588, 56547, 60651, 60741, 62451, 64323, 64494, 66789, 67509, 68454, 71649, 73674, 73998, 75105, 75717, 77325, 81963, 87813, 87957, 88542, 93627, 95049, 97074, 97326, 98925, 99477,
А вот список первых/минимальных решений при поиске с размещённым 29 или 31 или 37 или 41:
Код:
? forstep(x=29,1e5,29, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
1276, 9164, 10324, 16675, 20619, 22475, 44051, 45124, 66787, 87812, 87957, 97324,
? forstep(x=31,1e5,31, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
10323, 22475, 28675, 43803, 44051, 64325, 73997, 81964,
? forstep(x=37,1e5,37, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
1924, 10323, 19943, 28675, 31339,
? forstep(x=41,1e5,41, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
24723, 64493, 66789, 77326,
Видите, с 29 и 37 повезло, подошли первые же решения, а с 31 и тем более с 41 не повезло, пришлось проверять в 8 и 19 раз дальше. И если 31 ещё выгодно (проверяем с х10 шагом и хватило х8 интервала), то с 41 уже невыгодно (проверяем с х14 шагом, а проверить пришлось х19 интервала).
Для более сложных паттернов или размещением нескольких простых в несколько мест зависимость думаю будет ухудшаться.
Так что нет, поиск в высоту, как с необходимостью получается при замене pqrs на pq, менее выгоден поиска в ширину. Даже если сами паттерны будут проверяться чуть быстрее.
 Re: Пентадекатлон мечты
Аватара пользователя
Dmitriy40
Спасибо за развернутый ответ.

Dmitriy40 в сообщении #1735567 писал(а):
С другой стороны, замена pqrs на pq требует размещения двух простых (или куба одного), что увеличивает LCM, что замедляет все операции (особенно разложение).


Нет, нет. LCM не увеличивается. Там разница вида "подставить только $17^2$ близко к центру" или "подставить $17^2$ и $17$ ближе к краям".
А "форсированное" изменение позиции на хорошую, с добавлением нового простого и ростом LCM не окупается, да.

-- добавлено через 5 минут --

Huz
The hypothetical issue with possible skipped batches I mentioned in this message is now resolved.
After a few hours, I checked again and found "missing" batches in the output file.
The output delay ranged from 30 minutes to several hours. In any case, this isn't a pcoul issue, but rather a pipeline or output file lock issue.

But another small bug was discovered. With the -a2 -fr switches, the batch numbering in stdout overflows.
Here is an example, after filtering with a Python script:
Код:
...
4214906383,2^2.17,3,2.19^2,5^2.7,2^3.3^5,13,2,3,2^2.5,11,2.3.7^2,1,2^5,3^2.5,2,1,2^2.3,7.17^2,2.5.13^2,3,2^3.11^2,19.23^2,2.3^2,5,10750412587284770400,2,0,0,8,0,10,1,3,0,0
282352016,2^2.7,17.23^2,2.3^2,13^2.19,2^3.5^2,3.11^2,2,7,2^2.3,5,2,3^5,2^5,1,2.3.5.7^2,1,2^2.11.13,3,2.17^2,5,2^3.3^2,7,2.19^2,3,10750412587284770400,2,0,0,8,0,10,1,3,0,0
...


The overflow is also observed in the regular log file.
Код:
305 b4284972891: 2^2.7 19 2.3 5.11^2 2^3 3^5.17 2.13^2 7^2 2^2.3.5 . 2 3 2^5 5 2.3^2.7.11 . 2^2 3 2.5^2 13 2^3.3.19^2 7 2.17^2 3^2.5 (85336.95s) [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0]
305 b16473739: 2^2.3 . 2.5^2 3.19 2^3 . 2.3^2.7 5 2^2 3.11^2 2.13^2 . 2^5.3.5 7.17^2 2 3^2 2^2 5 2.3 . 2^3.7^2.11 3 2.5.19^2 13 (85869.14s) [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0]


-- добавлено через 16 минут --

2 All

Генерация паттернов с помощью pcoul перевалила экватор, и можно подвести итоги.
Найдено (без учёта зеркальных):

1. 1-2-19-2(10) - 10 шт.
2. 1-2-18-3(10) - 210 шт.
3. 1-3-18-2(10) - 718 шт.

Для приведения к "комплектам" Yadryara нужно умножить на 4. Всё совпало.

Ещё нашлись такие забавные батчи:
4. 0-4-18-2(10) - 158 шт.
5. 1-3-18-2(11), нет $3^5$ - 83 шт.
6. 1-3-18-2(11), есть $3^5$ - 631 шт.
7. 1-4-18-1(11), есть $3^5$ - 107 шт.
8. 1-3-19-1(11), есть $3^5$ - 55 шт.

 Re: Пентадекатлон мечты
Более 4млрд паттернов это конечно сильно!
Хорошо что не придётся столько ускорителей делать.

 Re: Пентадекатлон мечты
Аватара пользователя
Dmitriy40 в сообщении #1735570 писал(а):
Более 4млрд паттернов это конечно сильно!


Это ещё сильно уменьшено, на несколько порядков, путем ограничения степеней ключом
Код:
"-px3^5,1^11,1^23,1^47"

А размер выходного файла управляется фильтром на Питоне.

 Re: Пентадекатлон мечты
Аватара пользователя
Сегодня во второй части ночи и рано утром не мониторил.

Подоспела статистика по 2-му сорту. Действительно находки 20+ при вышеописанном подходе встречаются существенно реже.

Для первого сорта: 100800 / 541 ~ 186 (одна находка на 186 заданий)

Для второго сорта: 149280 / 612 ~ 244 (одна находка на 244 задания)

Но кэфы по валидсам отличаются пока довольно сильно.

Код:
Валидс                  от 0 до 1е58
по полю         1-й сорт            2-й сорт

     24                                    1
     23                2                  11   11.0
     22               26   13.0           30    2.7
     21              125    4.8          119    4.0
     20              388    3.1          451    3.8
____________________________________________
                     541                 612

 Re: Пентадекатлон мечты
EUgeneUS в сообщении #1735568 писал(а):
Huz
The hypothetical issue with possible skipped batches I mentioned in this message is now resolved.
After a few hours, I checked again and found "missing" batches in the output file.
The output delay ranged from 30 minutes to several hours. In any case, this isn't a pcoul issue, but rather a pipeline or output file lock issue.

Thanks for letting me know.

Цитата:
But another small bug was discovered. With the -a2 -fr switches, the batch numbering in stdout overflows.
It should be easy to increase a batch id from 32 to 64 bits, but it would be useful if I could understand when and why you need to rely on the batch id - are you asking pcoul to find and run individual batches beyond the first $2^{32}$?

I would probably suggest using a "-I" pattern to request a subset of batches: the batches will get a numbering specific to that pattern, so it's an easy way to cut down the range. But there have been several bugfixes in the handling of -I in recent weeks, so I had better prioritize getting a new release out so you can take advantage of those. (There are also some significant speedups, with more coming through.)

 Re: Пентадекатлон мечты
Аватара пользователя
Huz
Batch ID overflow is a completely insignificant issue.
1st. Taking into account the filtering of high degrees, an overflow occurred for the D(48,24) chains. It is unlikely that an overflow would also occur for any other chains of practical interest for the calculation. Incidentally, the number of batches for D(48,25) should be lower than for D(48,24).
2nd. If I’m running calculations for individual batches, I prefer the approach where the batch itself is explicitly specified, rather than just its identifier.

Of course, there was a slight surprise when I sorted the batch selection by their identifiers. But that is easily accounted for.

Naturally, the changes aimed at improving performance speed are of greater interest.
How would you rate the improvements made—to what extent do they increase calculation speed?

Of course, it will most likely remain impossible to compete with the computing power of BOINC project on the PARI\GP. However, if the speed were increased several-fold, one could attempt to find the next sequences for a divisor count of 24 or 96.

 Re: Пентадекатлон мечты
EUgeneUS в сообщении #1735623 писал(а):
Naturally, the changes aimed at improving performance speed are of greater interest.
How would you rate the improvements made—to what extent do they increase calculation speed?

It will vary greatly by target: a couple of years ago I estimated D(18,5) at 17 CPU years, and considered learning how to write GPU code to make a customized parallel solver to address it. A couple of hours working with Claude (Opus-5.5) this week brought a new approach in pcoul which solves it in 75m on my machine. (That found an optimal solution 16 times smaller than the previous upper bound, which probably reduces the search time by a factor of 4.) For $n \equiv 0 \pmod{12}$ cases I haven't done timings yet - there are multiple proposed patches that I have not finished reviewing - but I would guess in the range of 10-50% speed improvement for typical cases. There are also bugfixes, an embarrassing number of them - some are extremely unlikely to have led to missed cases (eg missing Pell solutions), others are much harder to analyse.
I am working now towards a new release, since it has been a while since I made one. If supporting 64-bit batch ids is as easy as I expect, then that will also be included.

 Re: Пентадекатлон мечты
Аватара пользователя
Yadryara в сообщении #1735655 писал(а):
Мы победили.

После почти непрерывной 7-часовой битвы, задания наконец-то начали считаться и в таблице участников я теперь занимаю почётное 291-е место :-) С 12 очками за первое посчитанное задание.

А Демис — аж 6-е место.

Нынче — 258 место. Я, кстати, не знаю хватит ли мне тех 230 очков, что набрал или нужно обязательно тысячу набрать.

Я пока считаю в один поток, в том смысле что у меня пока считается только одно задание одновременно. Это самое первое задание уложилось в 8 минут, а другие 13 посчитались за более долгие времена, в основном 11-12 минут.

Вот не знаю стоит ли сейчас экспериментировать с увеличением потоков. Или вновь заняться уже наконец рассказом о задачах. Вроде второе сейчас важнее.

 Re: Пентадекатлон мечты
Аватара пользователя
Дождался завершения генерации паттернов для $D(48,24)$ на pcoul. Чистого времени потребовалось менее двух суток. Вот последняя строка в штатном журнальном файле:
Код:
305 b3881459045: . 2.5.19^2 3 2^2 . 2.3^2 5.7.11.13^2 2^3 3 2.17^2 . 2^2.3.5 . 2.7 3^2 2^5 5^2 2.3.11^2 . 2^2.13 3.7^2.19 2.5 . 2^3.3^5 (163154.81s) [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0]


При расчете второй половины был сбой питания.
После сбоя питания pcoul восстановил работу нормально и досчитал до конца. Это могло бы привести к дублированию найденных паттернов за последние 10 минут перед сбоем питания.
Но привело к другому: в выходном файле отсутствует довольно большой кусок, в частности недостаёт паттернов видов 1-2-18-3(10) и 1-3-18-2(10). Скорее всего это связано с тем, что найденные строки могут писаться из конвейера в выходной файл с большими задержками, и большой кусок был утерян из-за сбоя питания.

Вывод: генерация паттернов с помощью pcoul может быть использована для любых цепочек, расчет которых может быть гипотетически выполнен. И будет занимать приемлемое время - менее 2-х суток.

Количество паттернов от длины цепочки меняется немонотонно. С ростом длины цепочки на 1:
1. Должен уменьшаться примерно в два раза, если не добавляется новое обязательное простое.
2. Увеличивается скачкообразно, если добавляется новое обязательное простое.

В частности, для цепочек $D(48,25) ... D(48,29)$ количество паттернов будет падать с ростом длины цепочки. Потом для $D(48,30)$ произойдёт резкий скачок вверх, а для $D(48,31)$ снова несколько упадет.

Если будет не лень, как-нибудь опишу подробно - как настраивать ключи pcoul, фильтрацию в скрипте на Питоне и дальнейшую обработку результатов в электронной таблице.

 Re: Пентадекатлон мечты
Аватара пользователя
EUgeneUS в сообщении #1735568 писал(а):
Для приведения к "комплектам" Yadryara нужно умножить на 4. Всё совпало.

Отлично. Спасибо что проверили.

EUgeneUS в сообщении #1735568 писал(а):
Ещё нашлись такие забавные батчи:

У меня тоже разные находились. И, по мере нахождения всё более перспективных болванок, ужесточал условия.

EUgeneUS в сообщении #1735623 писал(а):
Of course, it will most likely remain impossible to compete with the computing power of BOINC project on the PARI\GP.

ИИ перевёл так:

"Конечно, конкурировать с вычислительной мощностью проекта BOINC на [системе] PARI\GP, скорее всего, так и останется невозможным."

А зачем конкурировать? Присоединяйтесь к счёту.

Кстати, делается трансляция с gp-кода в C-код, а затем компиляция. У меня в Убунте это работало в 2.6 — 2.8 раза быстрее чем в интерпретаторе PARI/gp.

 Re: Пентадекатлон мечты
Аватара пользователя
Yadryara в сообщении #1735671 писал(а):
Кстати, делается трансляция с gp-кода в C-код, а затем компиляция. У меня в Убунте это работало в 2.6 — 2.8 раза быстрее чем в интерпретаторе PARI/gp.


Примерно настолько же выигрывает pcoul у скриптов на PARI\GP с хорошей предварительной фильтрацией.
Поэтому после реализации в pcoul расчета по явно заданному паттерну\батчу у меня пропал интерес к компиляции скриптов PARI\GP в исполняемый код.

 [ Сообщений: 4992 ]  На страницу Пред.  1 ... 329, 330, 331, 332, 333  След.


Соглашение о конфиденциальности | Общие правила

Powered by phpBB © 2000, 2002, 2005, 2007 phpBB Group