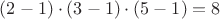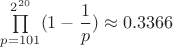Путь будут такие типовые вероятности:
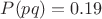
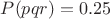
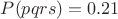
[...]
Не кажется ли, что второй тип паттернов будет считаться быстрее, и это может нивелировать разницу в вероятностях?
Да, при столь близких вероятностях может быть pq выгоднее - позволяют быстрее отбросить кандидата если хоть один делитель найден.
Только Ваши рассуждения не совсем точны: случай 1а идентичен обоим случаям 2а и 2б - так и так надо найти первый делитель и по остатку бракуем. А величина этого вот делителя не зависит от формата ожидания, только от самого числа, которое одинаково для любых форматов мест. Так что слово "долго" в 1а и 1б излишне, долго будет лишь если оба делителя велики, но тогда столь же долгими будут и 2а,2б.
Остаётся лишь случай 1б. Там да, если делитель найден небольшой, то второе разложение не сильно быстрее первого.
Но тут вмешивается другой момент: достаточно много делителей не слишком большие и обнаруживаются относительно быстро. Вероятность числу не иметь делителя меньше
(а до 1е9 вероятность 0.22). Т.е. значительная часть разложений, особенно при задействовании ECM, относительно быстро находит небольшие делители. И в таких случаях второе разложение не должно сильно ухудшать картину, оно ведь тоже с той же вероятностью найдёт ещё один небольшой делитель ... Да и вообще случай pqr при ожидаемых pqrs не 100% вероятен, так что влияние случая 1б на общее время ещё ослаблено.
Плюс не забывайте что в пункте 1а частное надо проверять на простоту, а в пунктах 2а и 2б лишь на составное, что несколько быстрее (помнится давало 10%-15% общей скорости, но уже не помню в каком варианте проверок).
С другой стороны, замена pqrs на pq требует размещения двух простых (или куба одного), что увеличивает LCM, что замедляет все операции (особенно разложение).
Но навскидку не готов сказать какой вариант стабильно быстрее, зависит от вероятностей и реализации проверок.
Но это всё про проверку одного кандидата.
А от замены pqrs на pq проверять придётся непрогнозируемо больше кандидатов. Да, Вы занимались этим расчётом, но на мой взгляд там сильны стат.флуктуации и для задачи поиска любого решения они сильнее влияют чем незначительные изменения мат.ожидания.
Вот пример для простейшего паттерна D12-3 список решений до 1е5:
Код:
? forstep(x=3,1e5,3, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
1275, 1926, 8226, 9162, 10323, 10674, 12051, 14049, 16677, 17181, 17667, 17739, 19941, 20619, 22476, 24723, 25773, 28677, 28926, 30474, 31338, 40077, 40914, 41274, 41517, 43803, 44052, 44163, 45123, 49149, 54585, 54588, 56547, 60651, 60741, 62451, 64323, 64494, 66789, 67509, 68454, 71649, 73674, 73998, 75105, 75717, 77325, 81963, 87813, 87957, 88542, 93627, 95049, 97074, 97326, 98925, 99477,
А вот список первых/минимальных решений при поиске с размещённым 29 или 31 или 37 или 41:
Код:
? forstep(x=29,1e5,29, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
1276, 9164, 10324, 16675, 20619, 22475, 44051, 45124, 66787, 87812, 87957, 97324,
? forstep(x=31,1e5,31, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
10323, 22475, 28675, 43803, 44051, 64325, 73997, 81964,
? forstep(x=37,1e5,37, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
1924, 10323, 19943, 28675, 31339,
? forstep(x=41,1e5,41, if(numdiv(x)<>12, next); if(numdiv(x-1)==12 && (numdiv(x+1)==12 || numdiv(x-2)==12) || numdiv(x+1)==12 && (numdiv(x+2)==12 || numdiv(x-1)==12), print1(x,", ")););
24723, 64493, 66789, 77326,
Видите, с 29 и 37 повезло, подошли первые же решения, а с 31 и тем более с 41 не повезло, пришлось проверять в 8 и 19 раз дальше. И если 31 ещё выгодно (проверяем с х10 шагом и хватило х8 интервала), то с 41 уже невыгодно (проверяем с х14 шагом, а проверить пришлось х19 интервала).
Для более сложных паттернов или размещением нескольких простых в несколько мест зависимость думаю будет ухудшаться.
Так что нет, поиск в высоту, как с необходимостью получается при замене pqrs на pq, менее выгоден поиска в ширину. Даже если сами паттерны будут проверяться чуть быстрее.