Научный форум dxdy

Математика, Физика, Computer Science, Machine Learning, LaTeX, Механика и Техника, Химия,
Биология и Медицина, Экономика и Финансовая Математика, Гуманитарные науки


На страницу Пред.  1, 2, 3, 4
 Re: Вероятность появления взаимно простых чисел
topic156404-60.html

 Re: Вероятность появления взаимно простых чисел
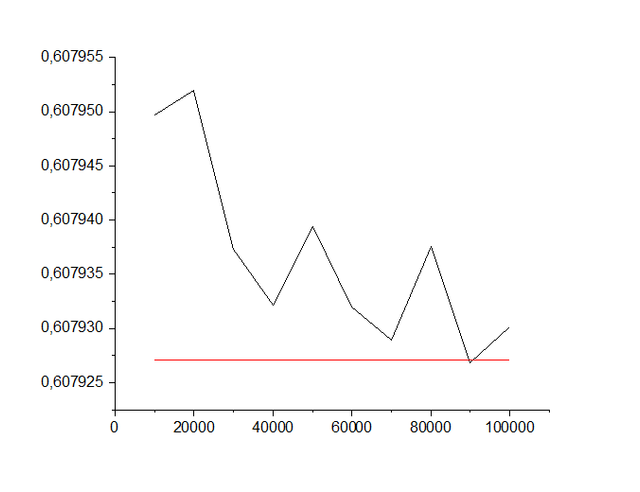
Ну вот, сделал с функцией Эйлера:

Изображение

Точка с N=100000 считается 1.9 секунд.
Ещё ускорю за счёт использования массивов.

 Re: Вероятность появления взаимно простых чисел
B3LYP
Зачем массивы?! И без них быстро:
Dmitriy40 в сообщении #1726186 писал(а):
А если не делать функцию от N, а сразу считать следующее N из предыдущего, то по идее ещё быстрее:
? m=6/Pi^2; q=0; s=-1; for(n=1,1e8, s+=eulerphi(n)*2; if(s<m*n^2, q++); ); q
time = 1min, 53,069 ms.
%1 = 182255

Количество исключений до N=10^8.
До 100 миллионов, Карл!

B3LYP в сообщении #1732509 писал(а):
Ну вот, сделал с функцией Эйлера:
А почему на точках
Dmitriy40 в сообщении #1726164 писал(а):
Рекомендую проверить N=820, 1276, 1422, 1926, 2080, 2640, 3160, 3186, 3250, 4446, 4720, 4930.
оно не упало ниже красного предела, а? До 100000 должно быть 192 проседаний ниже красной линии (и считается за десятки мс). Соответственно график или неправильный, или слишком грубый (не все натуральные точки проверены/показаны) - и в таком виде вводит в заблуждение. Когда все точки не влезают на график, лучше ставить не одну точку, а рисовать так называемые "усы" допуска (планки погрешностей, error bars), т.е. линию от минимума до максимума (а одно точное значение выделять например цветом или размером маркера), это гораздо информативнее.
 Re: Вероятность появления взаимно простых чисел
Dmitriy40 в сообщении #1732528 писал(а):
оно не упало ниже красного предела, а?


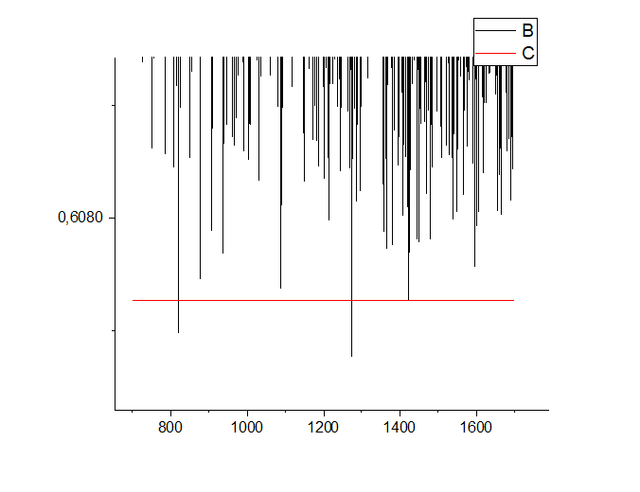
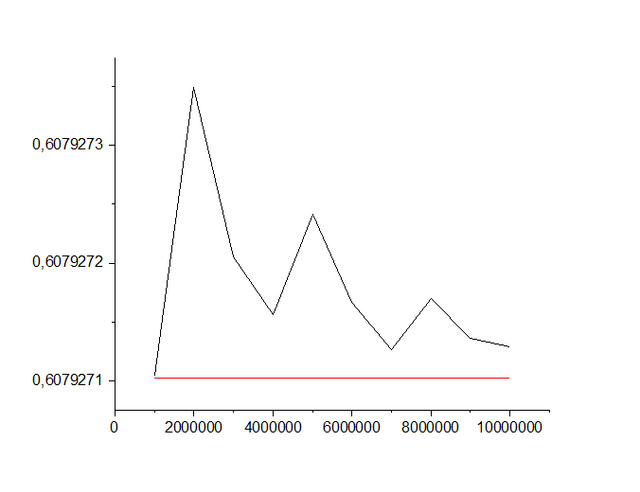
Пожалуйста:

Изображение

Изображение

Разница становится отрицательной на N=820, 1276, 1422.

 Re: Вероятность появления взаимно простых чисел
Такс, я ускорил свой алгоритм через использование динамических массивов – теперь заранее считается полный список наборов простых делителей для каждого числа от 2 до N, моим ускоренным алгоритмом. P для N(100000) посчиталась за 0.03 секунды. P для десяти миллионов посчиталась за четыре секунды. Это уже нормально, или можно ещё супер-ускорить?

Изображение

 Re: Вероятность появления взаимно простых чисел
B3LYP в сообщении #1732875 писал(а):
P для десяти миллионов посчиталась за четыре секунды. Это уже нормально, или можно ещё супер-ускорить?

Уже неплохо. У меня на планшете, если по-простому, то тоже около того:
Код:
? pt(n)=my(s=sum(i=1,n,eulerphi(i)));return((2*s-1)/(n^2))
%6 = (n)->my(s=sum(i=1,n,eulerphi(i)));return((2*s-1)/(n^2))
? pt(10^7)
time = 4,734 ms.
%7 = 60792712854483/100000000000000
?

 Re: Вероятность появления взаимно простых чисел
B3LYP
Если заморочиться и перейти на компилируемый язык (например Си), то можно ускориться на порядки.
10^7 считается на грани измерений времени (миллисекунды).
А например 10^12 считается за 4сек
Код:
~/gp-scripts $ \time ./pt_final 1000000000000
OpenMP threads: 8
n = 1000000000000
sum(phi) = 303963550927059804025910
pt(n) = 607927101854119608051819 / 1000000000000000000000000
        === task stats ===
        Command     : "./pt_final 1000000000000"
        User time   : 25.61s
        Real time   : 3.72s
        System time : 1.49s
        CPU         : 728%
        Memory RSS  : 425200KB
        Exit status : 0
        === end stats ===
~/gp-scripts $

Сложность около $O(n^{2/3})$

Это ещё к тому же многопоточно.

Дальше надо оптимизировать по памяти (например сегментировать решето), повышать коэффициент многопоточности и всё такое.

Так что вам есть куда расти :)

 Re: Вероятность появления взаимно простых чисел
B3LYP
Вообще вот эти задачи про точные вычисления чего-нибудь про простые числа, в основном сводятся к определению простоты. И очень часто - именно решетом, если числа последовательные.
Если у вас получается сублинейная сложность, то есть при росте входного числа в 10 раз время увеличивается меньше чем в 10 раз -- то это уже неплохо. Если в 6.7 раз -- хорошо. 3 раза - отлично.
Поэтому если вы хотите "отвелосипедить" вычисления с большим количеством последовательных простых чисел -- надо научиться видеть/понимать где какое решето применять.

 Re: Вероятность появления взаимно простых чисел
wrest в сообщении #1732946 писал(а):
Если у вас получается сублинейная сложность, то есть при росте входного числа в 10 раз время увеличивается меньше чем в 10 раз -- то это уже неплохо. Если в 6.7 раз -- хорошо. 3 раза - отлично.
B3LYP
Уточню/дополню: измерять надо не на малых интервалах, а на достаточно больших, там где и рост стабилизируется, и сами значения уже сильно превышают случайные флуктуации (я например обычно считаю все величины менее секунды нерелевантными). Ну либо проводить несколько одинаковых измерений и каким-то образом (это кстати хитрый вопрос не имеющий однозначного ответа) их усреднять. Очень многие об этом забывают и потом удивляются почему их измерения скажем на первом миллионе (не говоря уж про первую тысячу) простых чисел якобы опровергают теорию чисел ...

 Re: Вероятность появления взаимно простых чисел
wrest в сообщении #1732924 писал(а):
Если заморочиться и перейти на компилируемый язык (например Си), то можно ускориться на порядки.
10^7 считается на грани измерений времени (миллисекунды).
А например 10^12 считается за 4сек


Каким алгоритмом вы это просчитали? Можете привести код?
Я ещё раз провёл тесты: с моим старым алгоритмом, P для миллиона считается за 156 секунд, с новым за 0.3 секунды. Если кому надо, могу провести замеры что там в коде отнимает больше машинного времени, но понятно что скорее всего практически всё время уходит на разложение этого миллиона чисел на простые множители. В первом алгоритме это делается каждый раз заново для каждого числа (делим число на два, три, пять и так далее), а во втором работает мой алгоритм с решетом и динамическими массивами.
А у вас выходит используется ещё какая-то новая магическая формула для быстрого нахождения $\varphi(N) ?

 Re: Вероятность появления взаимно простых чисел
B3LYP в сообщении #1733038 писал(а):
А у вас выходит используется ещё какая-то новая магическая формула для быстрого нахождения $\varphi(N) ?

Нет, магия не применяется. Просто оптимизация вычислений. У вас неплохой прогресс.
Какая сейчас сложность вычислений?

 Re: Вероятность появления взаимно простых чисел
wrest в сообщении #1733040 писал(а):
Нет, магия не применяется. Просто оптимизация вычислений. У вас неплохой прогресс.
Какая сейчас сложность вычислений?


Не думаю, что такую разницу в скорости можно получить одной низкоуровневой оптимизацией. Я компилировал код на Delphi XE, он должен быть не более чем в два раза медленнее чем код скомпилированный на C++.
Можете показать ваш код? И что за метод вычисления функции Эйлера вы используете?
У меня сначала каждое число раскладывается на простые множители (с первым алгоритмом это делается для каждого числа заново, со вторым заранее считается массив из массивов с простыми множителями, через решето), потом эти множители правильно перемножаются. А у вас как?

 Re: Вероятность появления взаимно простых чисел
B3LYP в сообщении #1733221 писал(а):
Можете показать ваш код?

Вот одна из версий, подробно откомментированная:

(Оффтоп)

Код:
/*
* ============================================================================
*  Вычисление pt(n) = (2·S(n) - 1) / n², где S(n) = Σ φ(i), i = 1..n
* ============================================================================
*
*  МАТЕМАТИЧЕСКАЯ ЗАДАЧА:
*  ----------------------
*  Программа вычисляет вероятность того, что два случайно выбранных целых
*  числа из диапазона [1, n] окажутся взаимно простыми (т.е. их НОД = 1).
*
*  Эта вероятность выражается через сумму функции Эйлера φ(i):
*      pt(n) = (2 · Σ φ(i) - 1) / n²,   i = 1..n
*
*  По известной теореме теории чисел:
*      lim pt(n) = 6/π² ≈ 0.6079271018540266...
*       n→∞
*
*  Это знаменитая константа плотности взаимно простых чисел.
*
*  ОСНОВНАЯ ИДЕЯ АЛГОРИТМА:
*  -------------------------
*  Наивное вычисление S(n) = Σ φ(i) за O(n) слишком медленно для n ≥ 10⁹.
*  Используем тождество Дирихле:
*      Σ φ(d) = n,   где сумма по всем делителям d числа n
*       d|n
*
*  Суммируя по всем m ≤ n, получаем рекуррентную формулу:
*      S(n) = n(n+1)/2  -  Σ S(⌊n/k⌋),   k = 2..n
*
*  Ключевое наблюдение: среди значений ⌊n/k⌋ при k = 2..n существует
*  всего O(√n) различных значений. Это позволяет применить технику
*  "группировки одинаковых слагаемых" (hyperbola method / Dirichlet trick).
*
*  СЛОЖНОСТЬ:
*  ----------
*  - Время:  O(n^{2/3})  при оптимальном выборе порога K
*  - Память: O(n^{2/3})
*
*  Для n = 10¹³ это даёт ~20 секунд и ~1 ГБ памяти, тогда как наивный
*  алгоритм потребовал бы ~1500 часов и терабайты памяти.
*
*  СТРУКТУРА АЛГОРИТМА:
*  --------------------
*  1. Выбираем порог K ≈ n^{2/3}. Для всех m ≤ K значения S(m) вычисляем
*     классическим решетом Эратосфена за O(K log log K) и сохраняем как
*     префиксные суммы в массиве small_phi_sum[].
*
*  2. Для m > K используем рекуррентную формулу с мемоизацией:
*     - Группируем слагаемые по одинаковым ⌊m/k⌋
*     - Каждое уникальное значение ⌊m/k⌋ вычисляется один раз
*     - Результаты кэшируются в хэш-таблице
*
*  3. Параллелизация через OpenMP:
*     - На верхнем уровне рекурсии (S_par) распределяем вычисление
*       S(q) для различных q по потокам
*     - Внутри потоков используется последовательная рекурсия (S_seq)
*     - Общая мемоизация защищена мьютексом
*
*  4. Точная арифметика:
*     - Используем __int128, так как S(10¹³) ≈ 3·10²³ превышает
*       максимум uint64_t (1.8·10¹⁹)
*     - Результат выводим как несократимую дробь p/q
* ============================================================================
*/

#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#include <math.h>
#include <string.h>
#include <omp.h>

// Размер хэш-таблицы для мемоизации. Должен быть достаточно большим,
// чтобы избежать коллизий, но не слишком большим для экономии памяти.
#define MAX_MEMO 5000000

typedef __int128 int128;

// ----------------------------------------------------------------------------
//  Хэш-таблица с открытой адресацией (линейное пробирование) для мемоизации
// ----------------------------------------------------------------------------
typedef struct {
    uint64_t key;      // аргумент n, для которого сохранено S(n)
    int128   value;    // значение S(n)
    int      used;     // флаг занятости ячейки
} MemoEntry;

MemoEntry *memo;
omp_lock_t memo_lock;  // мьютекс для защиты от гонок при параллельной записи

void memo_init() {
    memo = calloc(MAX_MEMO, sizeof(MemoEntry));
    omp_init_lock(&memo_lock);
}

// Поиск значения в хэш-таблице. Возвращает 1, если найдено.
int memo_get(uint64_t key, int128 *value) {
    size_t idx = key % MAX_MEMO;
    for (int i = 0; i < 30; i++) {  // ограничиваем число пробирований
        size_t pos = (idx + i) % MAX_MEMO;
        if (!memo[pos].used) return 0;
        if (memo[pos].key == key) {
            *value = memo[pos].value;
            return 1;
        }
    }
    return 0;
}

// Вставка значения в хэш-таблицу с блокировкой.
void memo_put(uint64_t key, int128 value) {
    omp_set_lock(&memo_lock);
    size_t idx = key % MAX_MEMO;
    for (int i = 0; i < 30; i++) {
        size_t pos = (idx + i) % MAX_MEMO;
        if (!memo[pos].used) {
            memo[pos].key = key;
            memo[pos].value = value;
            memo[pos].used = 1;
            break;
        }
    }
    omp_unset_lock(&memo_lock);
}

// ----------------------------------------------------------------------------
//  Глобальные данные для порога K
// ----------------------------------------------------------------------------
int128 *small_phi_sum;  // small_phi_sum[m] = S(m) = Σ φ(i), i=1..m
uint64_t K;             // порог: для m ≤ K берём готовое значение из массива

// ----------------------------------------------------------------------------
//  Вычисление S(m) для m ≤ K через решето Эратосфена
// ----------------------------------------------------------------------------
//  Идея: инициализируем phi[i] = i, затем для каждого простого p
//  умножаем phi[i] на (p-1)/p для всех кратных p. Это даёт формулу:
//      φ(n) = n · Π (1 - 1/p),  где произведение по простым делителям p
//
//  После вычисления всех φ(i) строим префиксные суммы.
void compute_small_phi() {
    small_phi_sum = malloc((K + 1) * sizeof(int128));
    uint32_t *phi = malloc((K + 1) * sizeof(uint32_t));

    // Инициализация: phi[i] = i (параллельно)
    #pragma omp parallel for schedule(static)
    for (uint64_t i = 0; i <= K; i++) {
        phi[i] = (uint32_t)i;
    }

    // Решето: для каждого простого p обновляем его кратные
    // phi[i] -= phi[i] / p  эквивалентно  phi[i] = phi[i] * (p-1) / p
    for (uint32_t p = 2; p <= K; p++) {
        if (phi[p] == p) {  // p — простое (не было обновлено меньшими простыми)
            for (uint32_t i = p; i <= K; i += p) {
                phi[i] -= phi[i] / p;
            }
        }
    }

    // Префиксные суммы: small_phi_sum[m] = Σ phi[i], i=1..m
    small_phi_sum[0] = 0;
    for (uint64_t i = 1; i <= K; i++) {
        small_phi_sum[i] = small_phi_sum[i - 1] + phi[i];
    }

    free(phi);
}

// ----------------------------------------------------------------------------
//  Последовательная рекурсивная функция S(n)
// ----------------------------------------------------------------------------
//  Используется внутри OpenMP-потоков для вычисления S(q) при различных q.
//  Применяет рекуррентную формулу:
//      S(n) = n(n+1)/2 - Σ S(⌊n/k⌋),  k = 2..n
//
//  Группировка: вместо перебора всех k от 2 до n, группируем одинаковые
//  значения ⌊n/k⌋. Если q = ⌊n/k⌋, то это значение встречается для
//  k ∈ [k_start, n/q], то есть (n/q + 1 - k_start) раз.
int128 S_seq(uint64_t n) {
    if (n <= K) return small_phi_sum[n];  // базовый случай — из массива

    int128 cached;
    if (memo_get(n, &cached)) return cached;  // кэш

    int128 res = (int128)n * (n + 1) / 2;
    uint64_t k = 2;

    while (k <= n) {
        uint64_t q = n / k;           // текущее значение ⌊n/k⌋
        uint64_t nk = n / q + 1;      // первое k, где ⌊n/k⌋ станет меньше q
        res -= (int128)(nk - k) * S_seq(q);  // вычитаем (nk - k) · S(q)
        k = nk;
    }

    memo_put(n, res);
    return res;
}

// ----------------------------------------------------------------------------
//  Параллельная версия S(n) верхнего уровня
// ----------------------------------------------------------------------------
//  Собирает все уникальные значения q = ⌊n/k⌋ и распределяет их вычисление
//  по потокам OpenMP. Каждый поток вызывает S_seq(q) последовательно.
int128 S_par(uint64_t n) {
    if (n <= K) return small_phi_sum[n];

    int128 cached;
    if (memo_get(n, &cached)) return cached;

    // Предварительно выделяем массивы под все возможные ⌊n/k⌋.
    // Их количество не превосходит 2√n.
    uint64_t max_count = 2 * (uint64_t)sqrt((double)n) + 2;
    uint64_t *qs = malloc(max_count * sizeof(uint64_t));
    uint64_t *coeffs = malloc(max_count * sizeof(uint64_t));
    uint64_t count = 0;

    // Собираем уникальные q = ⌊n/k⌋ и соответствующие коэффициенты
    uint64_t k = 2;
    while (k <= n) {
        uint64_t q = n / k;
        uint64_t nk = n / q + 1;
        qs[count] = q;
        coeffs[count] = nk - k;
        count++;
        k = nk;
    }

    // Параллельно вычисляем S(q) для каждого уникального q
    int128 *s_values = malloc(count * sizeof(int128));

    #pragma omp parallel for schedule(dynamic, 4)
    for (uint64_t i = 0; i < count; i++) {
        s_values[i] = S_seq(qs[i]);
    }

    // Суммируем результаты (последовательно)
    int128 res = (int128)n * (n + 1) / 2;
    for (uint64_t i = 0; i < count; i++) {
        res -= (int128)coeffs[i] * s_values[i];
    }

    memo_put(n, res);
    free(qs);
    free(coeffs);
    free(s_values);
    return res;
}

// ----------------------------------------------------------------------------
//  Вывод 128-битного числа (стандартный printf не поддерживает __int128)
// ----------------------------------------------------------------------------
void print_int128(int128 n) {
    if (n == 0) {
        printf("0");
        return;
    }
    char buf[40];
    int pos = 39;
    buf[pos] = '\0';
    while (n > 0) {
        buf[--pos] = '0' + (int)(n % 10);
        n /= 10;
    }
    printf("%s", buf + pos);
}

// ----------------------------------------------------------------------------
//  НОД для сокращения дроби
// ----------------------------------------------------------------------------
int128 gcd(int128 a, int128 b) {
    while (b) {
        int128 t = b;
        b = a % b;
        a = t;
    }
    return a;
}

// ----------------------------------------------------------------------------
//  Главная функция
// ----------------------------------------------------------------------------
int main(int argc, char **argv) {
    if (argc < 2) {
        fprintf(stderr, "Usage: %s <n>\n", argv[0]);
        return 1;
    }

    uint64_t n = atoll(argv[1]);

    printf("OpenMP threads: %d\n", omp_get_max_threads());

    // Адаптивный выбор порога K:
    // - Для n ≤ 10¹² оптимально K = 10⁷ (быстрое решето, мало памяти)
    // - Для больших n используем K ≈ n^{2/3}, но не более 5·10⁷
    if (n <= 1000000000000ULL) {
        K = 10000000;
    } else {
        K = (uint64_t)pow((double)n, 2.0 / 3.0);
        if (K > 50000000ULL) K = 50000000ULL;
    }

    printf("K = %llu\n", (unsigned long long)K);
    compute_small_phi();
    memo_init();

    printf("Computing S(%llu)...\n", (unsigned long long)n);
    int128 sum = S_par(n);

    // Формируем точную дробь pt(n) = (2·S(n) - 1) / n²
    int128 p = 2 * sum - 1;
    int128 q = (int128)n * n;
    int128 g = gcd(p, q);
    p /= g;
    q /= g;

    long double result = (long double)p / (long double)q;

    printf("n = %llu\n", (unsigned long long)n);
    printf("sum(phi) = ");
    print_int128(sum);
    printf("\n");
    printf("pt(n) = ");
    print_int128(p);
    printf(" / ");
    print_int128(q);
    printf("\n");
    printf("pt(n) = %.15Lf\n", result);
    printf("6/pi^2 = %.15Lf\n", 6.0L / 3.14159265358979323846L / 3.14159265358979323846L);

    free(small_phi_sum);
    free(memo);
    omp_destroy_lock(&memo_lock);
    return 0;
}

 [ Сообщений: 58 ]  На страницу Пред.  1, 2, 3, 4


Соглашение о конфиденциальности | Общие правила

Powered by phpBB © 2000, 2002, 2005, 2007 phpBB Group