Научный форум dxdy

Математика, Физика, Computer Science, Machine Learning, LaTeX, Механика и Техника, Химия,
Биология и Медицина, Экономика и Финансовая Математика, Гуманитарные науки


На страницу Пред.  1, 2
 Re: You also need GatedMaxPool
Я тут размышляю над причиной, почему maxpool неплохо работает вместо трансформеров.

Трансформерный блок имеет сигнатуру (B, T, D) -> (B, T, D), где B - размер батча, T - длина последовательности, D - длина вектора данных. Искусственный интеллект сразу разобрался и посоветовал замену с шагом S = 1 и левым паддингом P = W - 1, где W - размер окна. В таком случае GateTopkPool подходит по сигнатуре вместо трансформерного блока. В процессе исследования я также установил, что вариант Topk = 1 (GatedMaxPool вместо тормознутого GatedTopkPool), W = 2 даёт лучшие результаты. В итоге рекомендуемые параметры: GatedMaxPool, W = 2, S = 1, P = [1, 0] - левый паддинг есть, правого нет. Также присутствует линейный слой с активацией с матрицей [D, D] - такой слой не изменяет размерность (B, T, D), просто он умный, с весами.

Я ведь пробовал заменить трансформеры на простые линейные слои с активацией и с матрицей [D, D], без maxpool. Эта штука не работает от слова совсем. Рецептивное поле равно 1. Слепота.

Линейные слои с активацией и с матрицей [D, D] способны управлять через maxpool передачей данных между соседними токенами, организуя рецептивное поле - вот почему работает GatedMaxPool.

P.S. Сравним с maxpool в классических нейросетях распознавания изображений. Основное отличие - это то, что у maxpool в распознавании изображений S = W. В изображениях maxpool выполняет настоящую роль пулинга - сжатия данных. Из-за того, что S больше единицы, рецептивное поле разрушается. Я бы попробовал ретроспективно вернуться к изображениям и попробовать S = 1 в maxpool и заменить при этом свёртку на линейные слои. Кажется это могло бы быть эффективной заменой свёрточных слоёв. Конечно же стандартный maxpool надо оставить, то есть скомбинировать два maxpool с S = 1 и S = W. При этом для первого варианта maxpool (который GatedMaxPool) можно поэкспериментировать W > 2, так как изображения более избыточны информативно. Можно выиграть в производительности вычислений.

 Re: You also need GatedMaxPool
Есть очень правдоподобная гипотеза, почему GatedMaxPool сходится быстрее, чем Transformer - благодаря именно более узкому рецептивному полю - нейросеть не рассматривает связи за пределами рецептивного поля и это очень годный подход в случае анализа простых текстов. Однако на более сложных задачах Transformer превзойдёт GatedMaxPool в разы.

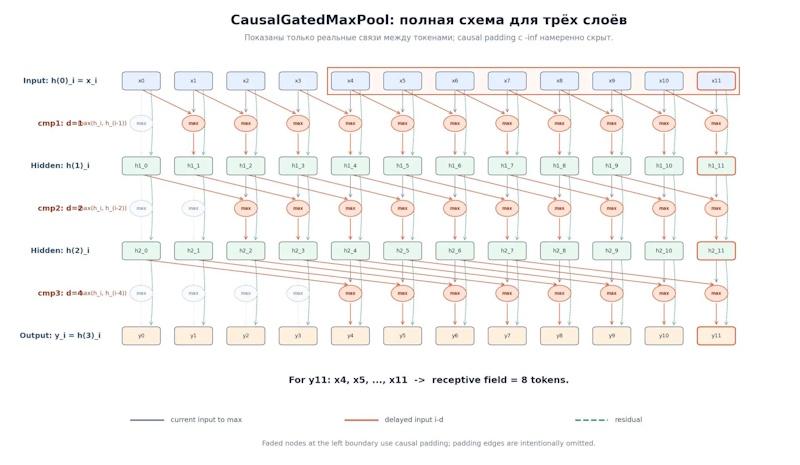
ИИ подсказывает решение в виде манипуляции с параметром dilation оконной функции. Надо сделать так и тогда рецептивное поле возрастёт экспоненциально ($R=2^N$) при сохранении количества слоёв:

Код:
        self.cmp1 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp2 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=2)
        self.cmp3 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=4)
        self.cmp4 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=8)
        self.cmp5 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=16)
        self.cmp6 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=32)
        self.cmp7 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=64)
        self.cmp8 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=128)


Я правда удалил dilation из кода, когда выкладывал на форум, возвращаю:

Код:
import torch
import torch.nn as nn
from typing import Union, Tuple
import torch.nn.functional as F

class CausalGatedMaxPool(nn.Module):
    def __init__(
        self,
        d_model: int,
        window_size: int = 2,
        dilation: int = 1,
    ):
        super().__init__()

        if d_model < 1:
            raise ValueError("d_model must be >= 1")
        if window_size < 2:
            raise ValueError("window_size must be >= 2")
        if dilation < 1:
            raise ValueError("dilation must be >= 1")

        self.d_model = int(d_model)
        self.window_size = int(window_size)
        self.dilation = int(dilation)

        # Один обучаемый коэффициент на каждую feature-компоненту.
        # Инициализация около ±1 сохраняет и max-, и min-пути с самого начала.
        self.gate = nn.Parameter(torch.empty(d_model))
        nn.init.normal_(self.gate, mean=0.0, std=1.0)

        self.proj = nn.Linear(d_model, d_model)
        self.act = nn.ReLU()
       
    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """
        x:       (..., T, d_model)
        returns: (..., T, d_model)
        """
        if x.ndim < 2:
            raise ValueError("Expected x with shape (..., T, d_model)")
        if x.size(-1) != self.d_model:
            raise ValueError(
                f"Expected last dim {self.d_model}, got {x.size(-1)}"
            )
   
        x = x * self.gate
   
        original_shape = x.shape
        T, D = original_shape[-2:]
        batch_shape = original_shape[:-2]
   
        # (..., T, D) -> (N, D, T)
        x = x.reshape(-1, T, D).transpose(1, 2)
   
        left_pad = (self.window_size - 1) * self.dilation
   
        # Важно: ручной asymmetric padding.
        # Аргумент padding у max_pool1d здесь не подходит:
        # он симметричный и ограничен.
        x = F.pad(x, (left_pad, 0), value=float("-inf"))
   
        # (N, D, T + left_pad) -> (N, D, T)
        pooled = F.max_pool1d(
            x,
            kernel_size=self.window_size,
            stride=1,
            padding=0,
            dilation=self.dilation,
        )
   
        # (N, D, T) -> (..., T, D)
        pooled = pooled.transpose(1, 2).reshape(*batch_shape, T, D)
   
        return self.act(self.proj(pooled))


Как работает dilation-трюк:

Изображение

P.S. ИИшка на схеме почему-то слово dilated заменил на delayed.

 Re: You also need GatedMaxPool
Есть вот такие теоретические изыскания:

1. Плотное (но узкое) перцептивное поле, назовём его равномерным, так как каждый входной токен в пределах перцептивного поля равнозначен и участвует в "голосовании" наравне с другими:
Код:
        self.cmp1 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp2 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp3 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp4 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)


2. Сильно разреженное в прошлом (но широкое) рецептивное - экспоненциальное. Прошлые токены получают меньше внимания.
Код:
        self.cmp1 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp2 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=2)
        self.cmp3 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=4)
        self.cmp4 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=8)


3. Промежуточный вариант - фибоначчиевый:
Код:
        self.cmp1 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp2 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=2)
        self.cmp3 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=3)
        self.cmp4 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=5)


4. Глобальный вариант - трансформер. Тоже можно использовать.

5. Комбинированный вариант:
Код:
        self.cmp1 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp2 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp3 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=1)
        self.cmp4 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=2)
        self.cmp5 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=3)
        self.cmp6 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=4)
        self.cmp7 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=8)
        self.cmp8 = CausalGatedMaxPool(d_model=D_MODEL, window_size=2, dilation=16)
        self.transformer1 = Transformer()
        self.transformer2 = Transformer()


Все представленные варианты не имеют дыр в рецептивном поле. Самый разреженный вариант - экспоненциальный - имеет самое широкое рецептивное поле, но повышенную слепоту в прошлое.

Комбинируя слои GPT-нейросети, можно добиться наилучшего соответствия архитектуры и данных, и в итоге получить более лёгкие вычисления и одновременно более высокую сходимость.

GatedMaxPool изучает зависимости между соседними токенами, что соответствует слоговым знаниям, частям слова и далее более глубокие слои GatedMaxPool изучают устойчивые словосочетания, завершается всё трансформерами, которые способны находить логические связи в предложениях, абзацах, главах, разделах, включая начало и конец текста.

 Re: You also need GatedMaxPool
От gate перед Maxpool я избавился из-за отсутствия особой разницы, в связи с этим стал разумным шаг - перенести линейный слой с активацией на место gate, до Maxpool, т.е. новый класс стал совсем простым:
Код:
CausalMaxpool = Linear + ReLU + Maxpool


Хочу обратить внимание (может кто-то ещё не въехал в тему), что Maxpool здесь необычный - каузальный, а именно:
1. Сравнение двух соседних токенов: kernel_size=2
2. Плотная структура, не разреженная: stride=1
3. Левосторонний паддинг: padding=(1, 0)
4. Возможность использования растущего dilation > 1 для более эффективного расширения рецептивного поля.

Именно такой Maxpool имеет каузальные свойства, то есть "не подглядывает в будущие токены".

Обновлённый класс (удалён gate, перенесёны Linear+ReLU):
Код:
import torch
import torch.nn as nn
import torch.nn.functional as F

class CausalMaxPool(nn.Module):
    def __init__(
        self,
        d_model: int,
        window_size: int = 2,
        dilation: int = 1,
    ):
        super().__init__()

        if d_model < 1:
            raise ValueError("d_model must be >= 1")
        if window_size < 2:
            raise ValueError("window_size must be >= 2")
        if dilation < 1:
            raise ValueError("dilation must be >= 1")

        self.d_model = int(d_model)
        self.window_size = int(window_size)
        self.dilation = int(dilation)

        self.proj = nn.Linear(d_model, d_model)
        self.act = nn.ReLU()
       
    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """
        x:       (..., T, d_model)
        returns: (..., T, d_model)
        """
        if x.ndim < 2:
            raise ValueError("Expected x with shape (..., T, d_model)")
        if x.size(-1) != self.d_model:
            raise ValueError(
                f"Expected last dim {self.d_model}, got {x.size(-1)}"
            )
   
        x = self.act(self.proj(x))
       
        original_shape = x.shape
        T, D = original_shape[-2:]
        batch_shape = original_shape[:-2]
   
        # (..., T, D) -> (N, D, T)
        x = x.reshape(-1, T, D).transpose(1, 2)
   
        left_pad = (self.window_size - 1) * self.dilation
   
        # Важно: ручной asymmetric padding.
        # Аргумент padding у max_pool1d здесь не подходит:
        # он симметричный и ограничен.
        x = F.pad(x, (left_pad, 0), value=float("-inf"))
   
        # (N, D, T + left_pad) -> (N, D, T)
        pooled = F.max_pool1d(
            x,
            kernel_size=self.window_size,
            stride=1,
            padding=0,
            dilation=self.dilation,
        )
   
        # (N, D, T) -> (..., T, D)
        pooled = pooled.transpose(1, 2).reshape(*batch_shape, T, D)
        return pooled


Итак, я провёл предварительные исследования, произвёл отбор кандидатов среди следующих:
1. Равномерное перцептивное поле (dilation = 1, 1, 1, ...)
2. Фиббоначчиево перцептивное поле (dilation = 1, 2, 3, 5, 8, 13, ...)
3. Экспоненциальное перцептивное поле (dilation = 1, 2, 4, 8, 16, 32, ...)
4. Комбинированную версию (dilation = 1, 1, 1, 2, 3, 5, 10, 20, ...)

Мне они все показались одинаково рабочими, поэтому я пока решаюсь остановиться на экспоненциальном варианте как на самом эффективном.
Провёл pretrained-этап создания GPT-модели, обучал на статьях русской википедии, далее чисто теоретически можно обучать в качестве чат-бота. Модель научилась закрывать скобки, довольно часто правильно ставит запятые и точки. Немного зацикливается, придумывает новые слова и словосочетания, короче, галлюцинирует.

Далее я испытал глубокую гибридную модель по принципу использования GatedDeltaNet в Qwen/Kimi:
1. Слои CausalMaxpool (4 шт.)
2. Positional Encoding
3. Dropout
4. Слои трансформеров (2 шт.)
5. Слои CausalMaxpool (4 шт.)
6. Positional Encoding
7. Dropout
8. Слои трансформеров (2 шт.)

Трансформеры сами по себе очень плохо обучаются, требуют пониженного learning rate и scheduling (learning rate изменяется по расписанию по определённому закону с "прогревом"). Гибрид из-за этого, в общем-то, тоже также следует обучать. Гибрид немного медленнее обучается, но предел сходимости (loss) гораздо ниже.

В общем CausalMaxpool следует рассматривать как "убийцу" GatedDeltaNet, а не самих трансформеров. Если GatedDeltaNet являются трансформерной структурой с линейным (точнее с субквадратичным) вниманием, то CausalMaxpool - это структура совершенно другой природы. Есть общее: а. вычислительная сложность также субквадратична, б. рецептивное поле также является локальным (не глобальным как у чистых трансформеров).

Далее предстоит сравнить CausalMaxpool с GatedDeltaNet в обучении.
 Re: You also need GatedMaxPool
Аватара пользователя
Mihaylo в сообщении #1732306 писал(а):
Именно такой Maxpool имеет каузальные свойства, то есть "не подглядывает в будущие токены".


Что удивительно.
Это пишет тот же самый человек, который рассуждал о какой-то ерунде применительно к причинам и следствиям в законе Ома. :shock: :mrgreen:

 Re: You also need GatedMaxPool
Я долго не давал отчёты по исследованию, потому что сочинял всякую фигню на тему причин и следствий в физике перепроверял производительность вычислений слоя CausalMaxPool.

Оказалось не так всё просто. Последний код выше - рабочий, и он достаточно быстро работает. Нюанс в следующем: при росте dilation (что очень важно для экспоненциального рецептивного поля), скорость вычислений падает также экспоненциально. Причина заключается в использовании библиотечной функции torch.nn.functional.pad (или коротко - F.pad). Примерно до dilation=128 всё хорошо, но потом всё очень плохо.

Есть другой код с рабочим названием V7, который работает численно неотличимо, но хуже по производительности при малых dilation и лучше при больших dilation.

Код:
class CausalMaxPool(nn.Module):
    """
    Оптимизированная causal dilated max-pooling операция (v7).

    ПОЧЕМУ v3-v6 не дали ускорения (все ~1.6-1.7x МЕДЛЕННЕЕ v0,
    константно, независимо от dilation): во всех них делались ДВА
    transpose -- x.transpose(-1,-2) чтобы применить pad к оси T, и
    обратный transpose(-1,-2) сразу после. В v0 transpose делается ОДИН
    раз в начале, и весь пайплайн (pad, max_pool1d) работает в layout
    (N, D, T) до самого конца -- никакого обратного разворота в
    середине вычислений. Два transpose на тензоре ~25MB (T=512, D=192,
    B=64) дают constant overhead ~1.4ms independent от dilation --
    что идеально совпадало с наблюдаемой картиной во всех версиях.

    v7: transpose делается ОДИН раз (как в v0), весь pipeline (pad,
    сдвиги/срезы, maximum) работает в layout (N, D, T), обратный
    transpose -- только в самом конце, один раз.
    """

    def __init__(
        self,
        d_model: int,
        window_size: int = 2,
        dilation: int = 1,
    ):
        super().__init__()

        if d_model < 1:
            raise ValueError("d_model must be >= 1")
        if window_size < 2:
            raise ValueError("window_size must be >= 2")
        if dilation < 1:
            raise ValueError("dilation must be >= 1")

        self.d_model = int(d_model)
        self.window_size = int(window_size)
        self.dilation = int(dilation)
        self.proj = nn.Linear(d_model, d_model)
        self.act = nn.ReLU()

    def _check_seq_len(self, T: int):
        left_pad = (self.window_size - 1) * self.dilation
        if left_pad >= T:
            warnings.warn(
                f"CausalMaxPool: left_pad={left_pad} >= T={T}.",
                stacklevel=2,
            )
        elif left_pad >= T // 4:
            warnings.warn(
                f"CausalMaxPool: left_pad={left_pad} составляет заметную "
                f"долю T={T} (>25%).",
                stacklevel=2,
            )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """
        x:       (..., T, d_model)
        returns: (..., T, d_model)
        """
        if x.ndim < 2:
            raise ValueError("Expected x with shape (..., T, d_model)")
        if x.size(-1) != self.d_model:
            raise ValueError(
                f"Expected last dim {self.d_model}, got {x.size(-1)}"
            )

        x = self.act(self.proj(x))

        original_shape = x.shape
        T, D = original_shape[-2:]
        batch_shape = original_shape[:-2]
        W = self.window_size
        Dl = self.dilation

        if __debug__:
            self._check_seq_len(T)

        span = (W - 1) * Dl

        # ОДИН transpose в начало, как в v0: (..., T, D) -> (N, D, T).
        x_t = x.reshape(-1, T, D).transpose(1, 2)  # (N, D, T)

        # pad ПО ПОСЛЕДНЕЙ (contiguous) оси T -- дёшево, как в v0.
        x_padded = F.pad(x_t, (span, 0), value=float("-inf"))  # (N, D, T+span)

        # Накопительный running max ЧЕРЕЗ СРЕЗЫ ПО ПОСЛЕДНЕЙ ОСИ --
        # никакого дополнительного transpose внутри цикла.
        result = x_padded[..., span:span + T]
        for k in range(1, W):
            offset = (W - 1 - k) * Dl
            shifted = x_padded[..., offset:offset + T]
            result = torch.maximum(result, shifted)

        # ОДИН transpose обратно в конце, как в v0.
        pooled = result.transpose(1, 2).reshape(*batch_shape, T, D)
        return pooled


Казалось бы, надо написать функцию, которая будет переключать между исходным вариантом CausalMaxPool (V0) и V7 в зависимости от dilation. Но оказалось, что мои исследования недостаточно компетентные. Оказывается, вместо того, чтобы вызывать отдельные функции в Python-скрипте, можно скомпилировать скрипт с помощью Triton как единую функцию. Код Python почти не меняется, просто достаточно обернуть ту или иную функцию или класс магической обёрткой torch.compile(). Компиляция займёт время, но выполнение кода ускорится.

Оказалось, компиляция кода V0 практически ничего не меняет, так как компилятор не может "заглянуть под капот" F.pad() и оптимизировать его. Компиляция V7 ускоряет код примерно в 2 раза при dilation=1 и далее обеспечивает производительность практически независимой от dilation. То есть V7 - абсолютный победитель при условии, что функция будет скомпилирована с помощью Triton.

Компиляция всей GPT-модели, а не отдельного CausalMaxPool, ещё немного ускоряет производительность. Буду сравнивать с TransformerGPT-моделью, которую тоже откомпилирую целиком. Нет смысла сравнивать друг с другом неоптимизированные коды.

 Re: You also need GatedMaxPool
Случайно запустил классическую трансформерную GPT-модель с learning rate = 1e-3 и как-то вдруг эта скорость не привела к её коллапсу. Не знаю, раньше модель не работала с такой скоростью нормально. Вывод, который я сделал по итогу: CausalMaxPool годится только в подмётки Transformer. Да, CausalMaxPool быстрее примерно в 2,5 раза, но предел сходимости сильно ограничен. Мне кажется, языковая модель с CausalMaxPool может быть пригодна для комментирования процесса работы основной LLM (как я вижу в Perplexity довольно глупую комментирующую модель). Такое ощущение, что быстрая модель Sonar от Perplexity - это какой аналог LLM на базе CausalMaxPool.

Доказывать свои слова не вижу смысла, это просто суждения, нужны мысли, куда двигаться дальше. Тем более найдена очень простая нейроструктура, у которой известны теоретические недостатки, но она почти работает.

 [ Сообщений: 22 ]  На страницу Пред.  1, 2


Соглашение о конфиденциальности | Общие правила

Powered by phpBB © 2000, 2002, 2005, 2007 phpBB Group