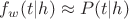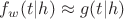Научный форум dxdy

Математика, Физика, Computer Science, Machine Learning, LaTeX, Механика и Техника, Химия,
Биология и Медицина, Экономика и Финансовая Математика, Гуманитарные науки


На страницу Пред.  1, 2
 Re: Часто ли ИИ формирует ложные сообщения?
mihaild в сообщении #1735889 писал(а):
И источников галлюцинаций два - плохое исходное распределение, и плохое приближение.
А можно на рабоче-крестьянский перевести эти термины? "исходное распределение" - это, я так понимаю, корпус текстов, на которых училась модель? А "приближение" - это что?

mihaild в сообщении #1735889 писал(а):
Сегодня какая-то смесь, и скорее больше проблем с качественным обучающим распределением.
У Панчина недавно видел ссылку на такую работу: https://arxiv.org/abs/2603.11749 Суть вкратце: правда - это артефакт сжатия. Правдивая информация структурирована и систематизирована, вранье и выдумки - это случайный шум. Шум отсеивается, структурированная информация сохраняется - и это по умолчанию, даже если специально не учить нейросеть "как правильно", она сама догадается (хотя и не всегда, конечно). Мне эта новость внушает оптимизм.

 Re: Часто ли ИИ формирует ложные сообщения?
Аватара пользователя
rockclimber в сообщении #1736054 писал(а):
А можно на рабоче-крестьянский перевести эти термины? "исходное распределение" - это, я так понимаю, корпус текстов, на которых училась модель? А "приближение" - это что?
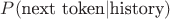
Рассмотрим первую часть обучения, которая называется pre-training. У нас есть корпус текстов, который можно считать выборкой из распределения $P(\text{next token} | \text{history})$. А сама по себе модель - это семейство таких распределений, параметризованное весами, $f_w(t | h)$. И обучение - это подбор $w$, такого что $f_w(t | h) \approx P(t | h)$.
Естественно, на практике у нас нет "истинного" распределения текстов, а есть только выборка, но можно притвориться, что есть. Хотя оно и зависит от того, какую выборку текстов мы рассматриваем (и их еще можно взвешивать). Но понятно, что если мы берем просто тексты из интернета, то у строки "Найдем производную от $x^2$" наиболее вероятное продолжение - какое-нибудь более-менее внятное, а у "Вот доказательство гипотезы Коллатца:" - бессмысленное нагромождение формул.
До недавнего времени (последних нескольких лет) проблема была, в первую очередь, с приближением - $f_w(t|h)$ оказывалось настолько далеко от распределения обучающих текстов, что и строку "Найдем производную от $x^2$" продолжало просто какими-то случайными словами, которые часто встречаются в математических текстах. Сейчас эта проблема более-менее решена - стандартный уровень бредовости из интернета модели воспроизводят легко.
И теперь основная задача при обучении - это как раз построить какую-то "хорошую" обучающую выборку, чтобы ближайшее к ней распределение из выразимых моделью было "хорошим".
rockclimber в сообщении #1736054 писал(а):
Суть вкратце: правда - это артефакт сжатия. Правдивая информация структурирована и систематизирована, вранье и выдумки - это случайный шум.
Это вроде довольно очевидно. Но толку от этого не очень много, потому что слабые (могущие выразить лишь немногие распределения) модели не могут выразить и "правду", а сильные могут выразить и шум.

 Re: Часто ли ИИ формирует ложные сообщения?
mihaild в сообщении #1736065 писал(а):
У нас есть корпус текстов, который можно считать выборкой из распределения $P(\text{next token} | \text{history})$


Для простоты будем считать, что генерация пока не началась. Тогда, насколько я понимаю, $\text{history}$ это промпт. Где я возьму хотя бы один текст, начало которого совпадает с моим промптом?

 Re: Часто ли ИИ формирует ложные сообщения?
Аватара пользователя
ozheredov в сообщении #1736067 писал(а):
Где я возьму хотя бы один текст, начало которого совпадает с моим промптом?
Нигде, и этого не требуется. Если хотите более строго - наш корпус текстов задает определенное на встречающихся префиксах условное распределение $g(t | h)$ (которое для уникальных префиксах сосредоточено в одном слове). И мы подбираем $w$, такое что $f_w(t | h) \approx g(t | h)$ (на реально встречающихся префиксах).

 Re: Часто ли ИИ формирует ложные сообщения?
ozheredov в сообщении #1736067 писал(а):
Где я возьму хотя бы один текст, начало которого совпадает с моим промптом?

Это называется генерализация - обобщающая способность: в тексте "нужно найти производную функции" видеть почти то же самое, что и в тексте "для этой функции будем искать dy/dx", но более-менее строго отделять от "не первая и даже не вторая производная функции".

mihaild в сообщении #1736070 писал(а):
$f_w(t | h) \approx g(t | h)$

 Re: Часто ли ИИ формирует ложные сообщения?
mihaild в сообщении #1736065 писал(а):
Это вроде довольно очевидно.
Да, сейчас мне это очевидно - когда я об этому узнал. А до этого было неочевидно. Ну вам может было очевидно, вы больше с этим работаете. Сам Панчин, когда писал свой пост, начал с того, как нейросети отличают науку от лженауки. Они, в целом, понимают, что гомеопатия, астрология, плоская Земля и т. п. - это чушь. Но как они это делают? Я, например, тоже об этому задумывался, и мне казалось, что им специально размечают данные - этот текст лженаучный, этот нет. А тут, похоже, этого и не требуется.

 Re: Часто ли ИИ формирует ложные сообщения?
rockclimber в сообщении #1736287 писал(а):
нейросети отличают науку от лженауки. Они, в целом, понимают, что гомеопатия, астрология, плоская Земля и т. п. - это чушь.


Недавно задавал иишке вопрос "Является ли Паланджянц Левон Жирайрович мракобесом. На протяжении четырёх-пяти ответов он АГРЕССИВНО убеждал меня, что это уважаемый учёный. Только специально подобранная цитата из его книги Универсальная физика, содержащая слово кочудорасчленение, убедила его в обратном.

 Re: Часто ли ИИ формирует ложные сообщения?
Mikhail_K в сообщении #1735850 писал(а):
задали вопрос, уточняйте, к какому году и месяцу

Когда-то читал тему (дату не помню), в которой кто-то утверждал, что правду говорят только дураки. Если это утверждение истинно, то тогда получается, что сам утверждающий дурак. В противном случае это утверждение ложно, правду могут говорить все. Как будет правильнее?

-- добавлено через 3 минуты --

Вопрос к ИИ: Применяют ли ИИ для управления машинами или технологическими процессами?

Ответ ИИ: Да, искусственный интеллект активно применяют для управления машинами и технологическими процессами. Он интегрируется в автоматизированные системы управления технологическими процессами (АСУ ТП) и бортовую электронику техники. Основные сферы применения:
Управление производством и линиями:
Алгоритмы контролируют работу конвейеров, роботов-манипуляторов и логистических тягачей (например, координация сотен роботов на заводах BMW или Foxconn).
ИИ оптимизирует микроклимат, энергопотребление и режимы работы оборудования (например, управление системами HVAC на предприятиях Tesla).
Мониторинг и предиктивное обслуживание:
Системы анализируют данные с датчиков в реальном времени, предсказывают поломки до их возникновения и предотвращают аварийные остановки (например, решение POSS от Strukton Rail сократило число технических сбоев вдвое).
Контроль качества:
Системы компьютерного зрения на базе ИИ мгновенно выявляют дефекты продукции (например, решения Google Cloud Visual Inspection на предприятиях Foxconn).
Управление транспортом и автотехникой:
ИИ лежит в основе систем помощи водителю (ADAS), адаптивного круиз-контроля, управления трансмиссией и автопилотов.

-- добавлено через 4 минуты --

Вопрос к ИИ: Создавали ли ошибки ИИ аварийные ситуации при управлении машинами или технологическими процессами?

Ответ ИИ: Да, ошибки и сбои искусственного интеллекта неоднократно приводили к аварийным ситуациям, ДТП и инцидентам на производстве. В отличие от классического софта, работающего по жестким алгоритмам, ИИ полагается на вероятностные модели. Когда система сталкивается с редкими ситуациями (так называемыми edge cases), на которых она не обучалась, или неверно интерпретирует данные с датчиков, это приводит к критическим сбоям.
Ниже приведены ключевые примеры таких инцидентов в разных сферах.

1. Автономный транспорт и беспилотные автомобили.
В сфере беспилотного вождения зафиксировано больше всего резонансных инцидентов, поскольку машины с ИИ делят дороги общего пользования с людьми.
Искажение восприятия («слепое пятно» ИИ): В 2018 году беспилотный автомобиль Uber насмерть сбил пешехода в Аризоне. Система компьютерного зрения классифицировала женщину с велосипедом сначала как неопознанный объект, затем как автомобиль и лишь в последний момент как велосипед, из-за чего алгоритм не успел вовремя рассчитать траекторию торможения.
Игнорирование статичных препятствий: Системы помощи водителю (такие как Autopilot и FSD в Tesla, а также системы в китайских электромобилях Aito/Huawei и Xiaomi) неоднократно попадали в аварии на высокой скорости, врезаясь в стоящие на трассе пожарные машины, перевернутые грузовики или бетонные отбойники. Алгоритмы фильтрации радаров и камер ошибочно принимали неподвижный крупный объект за мост или элемент дорожной инфраструктуры.
Сбои при обновлении ПО: В 2022 году роботакси компании Cruise после неудачного апдейта совершило резкий маневр и заблокировало перекресток, спровоцировав столкновение, а в других случаях группы машин этой компании массово «застывали» на улицах Сан-Франциско, парализуя городской трафик.

2. Промышленность и технологические процессы.
На заводах и фабриках ИИ чаще всего используется для предиктивной аналитики, оптимизации и управления конвейерами. Ошибки здесь обычно связаны с переобучением моделей или неверным распределением приоритетов.
Инциденты с логистическими роботами: На автоматизированных складах (например, Amazon) роботы под управлением ИИ-систем распределения заказов периодически сталкивались, повреждали стеллажи или блокировали проезды из-за «галлюцинаций» в конструировании маршрутов при высокой плотности машин. В одном из случаев робот случайно проткнул баллон с химикатами (капсаицином), из-за чего потребовалась эвакуация сотрудников.
Сбои оптимизации сетей: При попытках внедрить ИИ для управления энергетическими или коммунальными потоками алгоритмы, стремясь максимизировать экономию, могут выводить технологические параметры в критические зоны. Без жестких классических систем защиты (Safety Interlocks) это приводило к локальным гидроударам на трубопроводах или перегрузкам подстанций.

3. Военная техника и БПЛА.
Применение автономного ИИ в управлении беспилотниками создает риски из-за жесткой ориентации алгоритма на выполнение заложенной математической цели.
Ошибки распознавания целей: В боевых условиях дроны с ИИ, обученные на конкретные силуэты техники, могут атаковать гражданские объекты. Например, зафиксированы случаи, когда автономный дрон атаковал гражданскую заправку, распознав баки с пропаном как военную цель.

Главные причины аварий по вине ИИ:
1. Контекстная слепота: ИИ отлично видит паттерны, но не понимает физической сути происходящего.
2. Эффект «недокументированной ситуации» (Edge Cases): Если в обучающей выборке не было грузовика необычной формы или человека в нестандартном костюме, ИИ может проигнорировать их.
3. Эффект убаюкивания оператора (Automation Complacency): Человек привыкает к тому, что ИИ работает идеально, теряет бдительность и не успевает перехватить управление в критические 1-2 секунды до аварии.
 Re: Часто ли ИИ формирует ложные сообщения?
Serg53 в сообщении #1736535 писал(а):
Когда-то читал тему (дату не помню), в которой кто-то утверждал, что правду говорят только дураки. Если это утверждение истинно, то тогда получается, что сам утверждающий дурак. В противном случае это утверждение ложно, правду могут говорить все. Как будет правильнее?


Если X хочет запутать Y и говорит для этого только ложь, то Y легко заставит X раскрыть правду через бинарное дерево ответов (попробуйте догадаться, как именно это будет выглядеть скажем в случае выведывания пин-кода от кредитки). Поэтому врун должен обязательно иногда говорить правду

 [ Сообщений: 24 ]  На страницу Пред.  1, 2


Соглашение о конфиденциальности | Общие правила

Powered by phpBB © 2000, 2002, 2005, 2007 phpBB Group